This post is not translated yet, so it is shown in Korean.
다운스트림 연산 효율 최적화를 위한 원본 HTML 적재 크롤러 구현
중복 크롤링과 리니지 단절을 URL 정제·해시 식별자·LEFT Anti Join·Async Playwright로 해결
PlaywrightS3AirflowdbtData Lineage
문제
- 다운스트림 종속성에 따른 재처리 비용 증가:
크롤링 단계에서 즉시 링크 메타데이터를 추출하면, 다운스트림의 추출 스키마 요구사항이 바뀌거나 에러가 발생할 때 외부 웹페이지를 다시 크롤링해야 하는 재처리 (Backfill) 비용이 발생합니다. - 중복 크롤링으로 인한 네트워크/컴퓨팅 리소스 낭비:
명확한 Entry Point가 없는 트렌딩 피드(나무위키, 유튜브, 네이버 뉴스, Velog 등)를 매시간(Hourly) 수집하기 때문에 다량의 중복된 링크가 수집되어, 동일한 HTML 페이지를 불필요하게 반복 Fetch하는 낭비가 발생했습니다. (수집 링크 중 약 40%가 중복) - 크로스 플랫폼 간 데이터 리니지 단절:
수집된 URL과 HTML 원천 데이터가 OLAP 및 OLTP 등 여러 저장소에 걸쳐 변환·적재되면서, 특정 HTML 파일이 S3에 언제, 어떤 경로로 저장되었는지 추적이 불가능해 에러 디버깅에 오랜 시간이 소요됐습니다.

도출된 기술적 요구사항줘
- 데이터 불변성(Immutability) 확보:
다운스트림 로직 변경에 유연하게 대응할 수 있도록, 파싱되지 않은 순수한 ‘원천(Raw) HTML’을 우선적으로 보존하는 아키텍처가 필요 - 비용 효율적인 중복 제거(Deduplication) 체계:
수집된 링크 목록 중 이미 확보한 데이터를 식별하고 필터링하여, 실질적으로 필요한 웹페이지에 대해서만 Fetch를 수행하도록 파이프라인 최적화 - 엔드투엔드(End-to-End) 리니지 및 식별 체계 구축:
URL 메타데이터와 S3에 저장된 실제 HTML 파일 간의 명확한 식별(Mapping) 체계를 구축하여, 데이터의 출처와 흐름을 100% 추적할 수 있는 환경
해결

- URL 정제 및 해시 기반 고유 식별자(Identifier) 발급:
URL에서 불필요한 추적 파라미터(Parameter)와 프래그먼트(Fragment)를 제거(Clean URL)해 동일한 웹페이지가 다른 주소로 인식되는 것을 막고, 정제된 URL을 해싱·포맷팅(UUID)해 각 페이지에 대한 고유 식별자를 생성했습니다. - LEFT Anti Join 기반의 Fetch 대상 필터링 (Deduplication & Refresh):
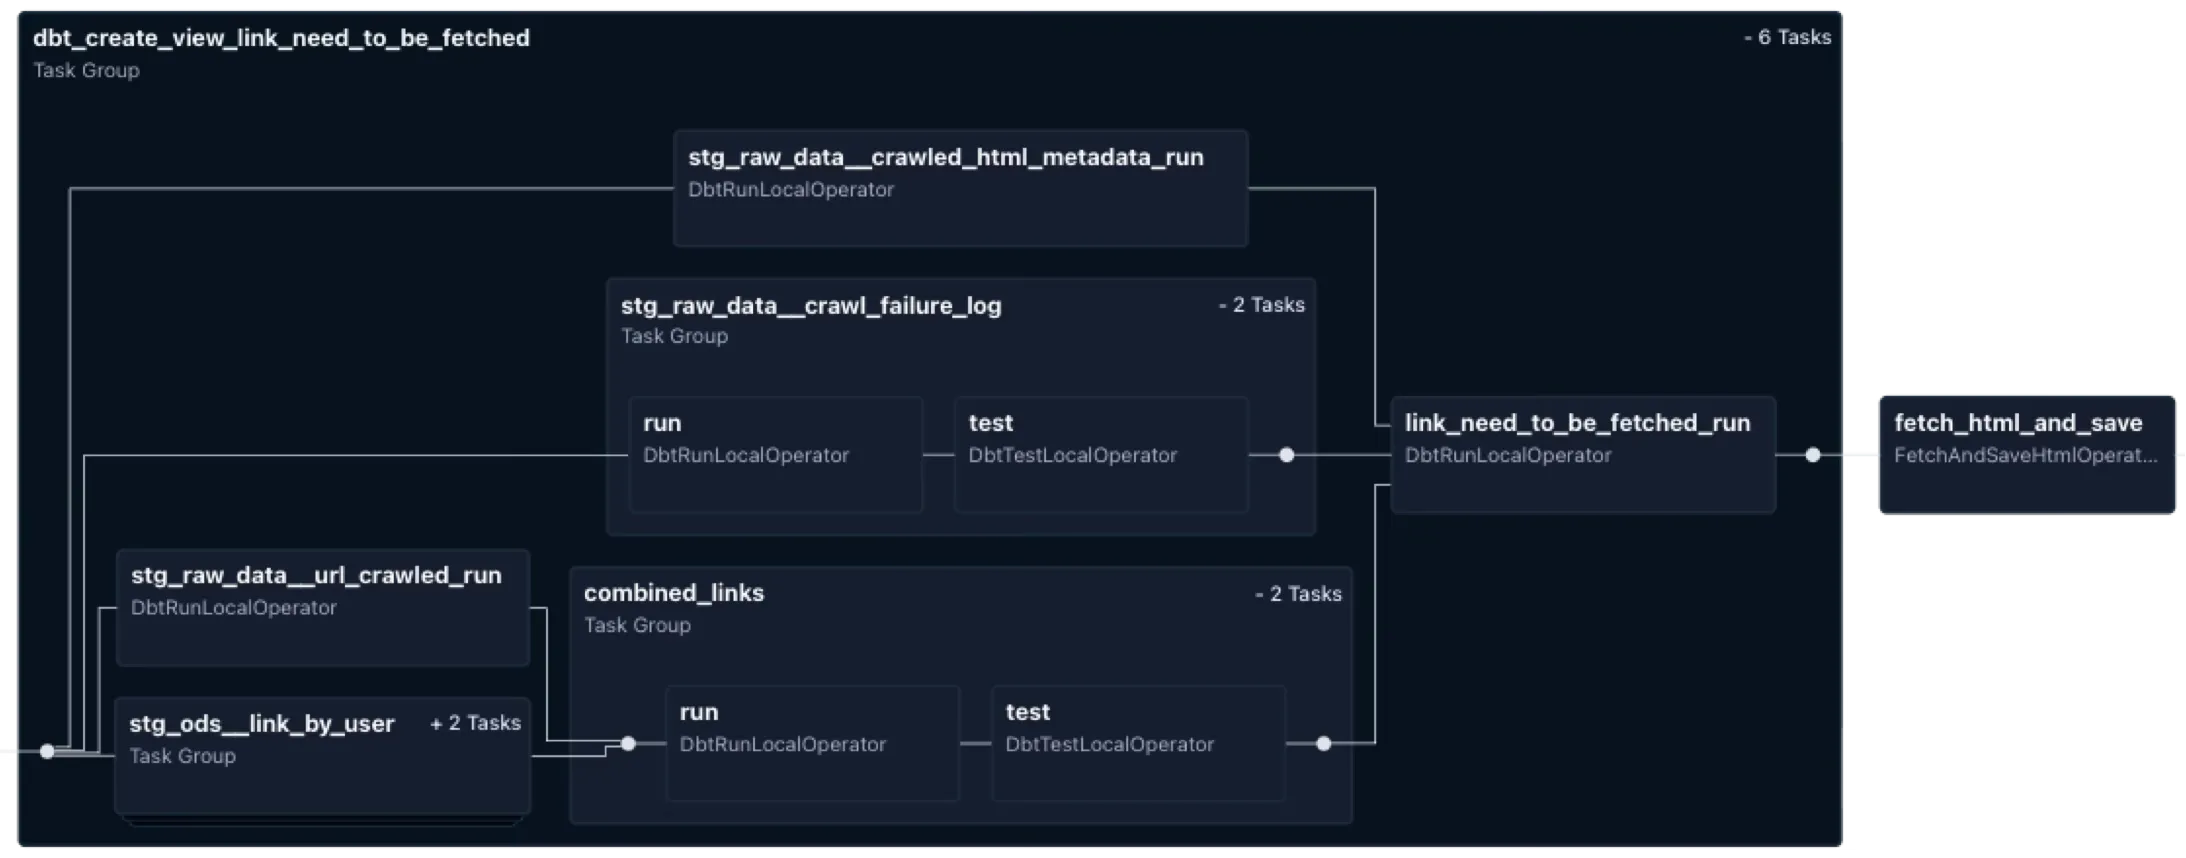
수집 대상 URL 목록을 기존 URL_META 테이블과 LEFT Anti Join해 중복을 필터링하고, created_at 조건으로 완전히 새로운 URL이거나 마지막 수집일로부터 7일이 경과해 갱신(Refresh)이 필요한 URL만 Fetch하도록 구현했습니다. - Async Playwright 기반 비동기 병렬 수집:
필터링을 통과한 URL에 Async Playwright를 도입해 동적 렌더링 및 Fetch를 비동기로 병렬 처리하고, 수집에 성공한 HTML 정보를 URL_META 테이블에 업데이트해 S3 객체와 메타데이터 간 매핑을 유지했습니다.
결과
- 노이즈 정제 및 LEFT Anti Join을 통한 네트워크 I/O 최적화:
URL 파라미터 정제와 URL_META LEFT Anti Join을 결합해 중복 Fetch를 원천 차단하고, 무의미한 외부 트래픽 호출과 Playwright 구동 리소스를 획기적으로 줄였습니다. - 단일 식별자(Identifier) 기반의 완벽한 데이터 리니지(Lineage) 구축:
해싱된 Identifier를 전역적으로 활용해 시스템 간 데이터 이동 시 데이터 파편화를 해결하고, 장애나 파싱 에러 발생 시 특정 HTML이 언제, 어떤 URL로부터 수집되었는지 100% 추적 가능한 관측성(Observability)을 확보했습니다. - 수집 처리량(Throughput) 극대화 및 다운스트림 재처리(Backfill) 유연성 확보:
Async Playwright 병렬 처리로 네트워크 I/O 바운드로 인한 대기 시간을 최소화해 전체 수집 파이프라인의 처리량을 높였고, S3에 원천 데이터를 보존해 새로운 추출 요구사항이나 파싱 오류로 재처리할 때도 원천 웹페이지 재방문 없이 즉각적이고 안전하게 대규모 과거 데이터를 재처리할 수 있는 구조를 만들었습니다.