This post is not translated yet, so it is shown in Korean.
GITSIGHT
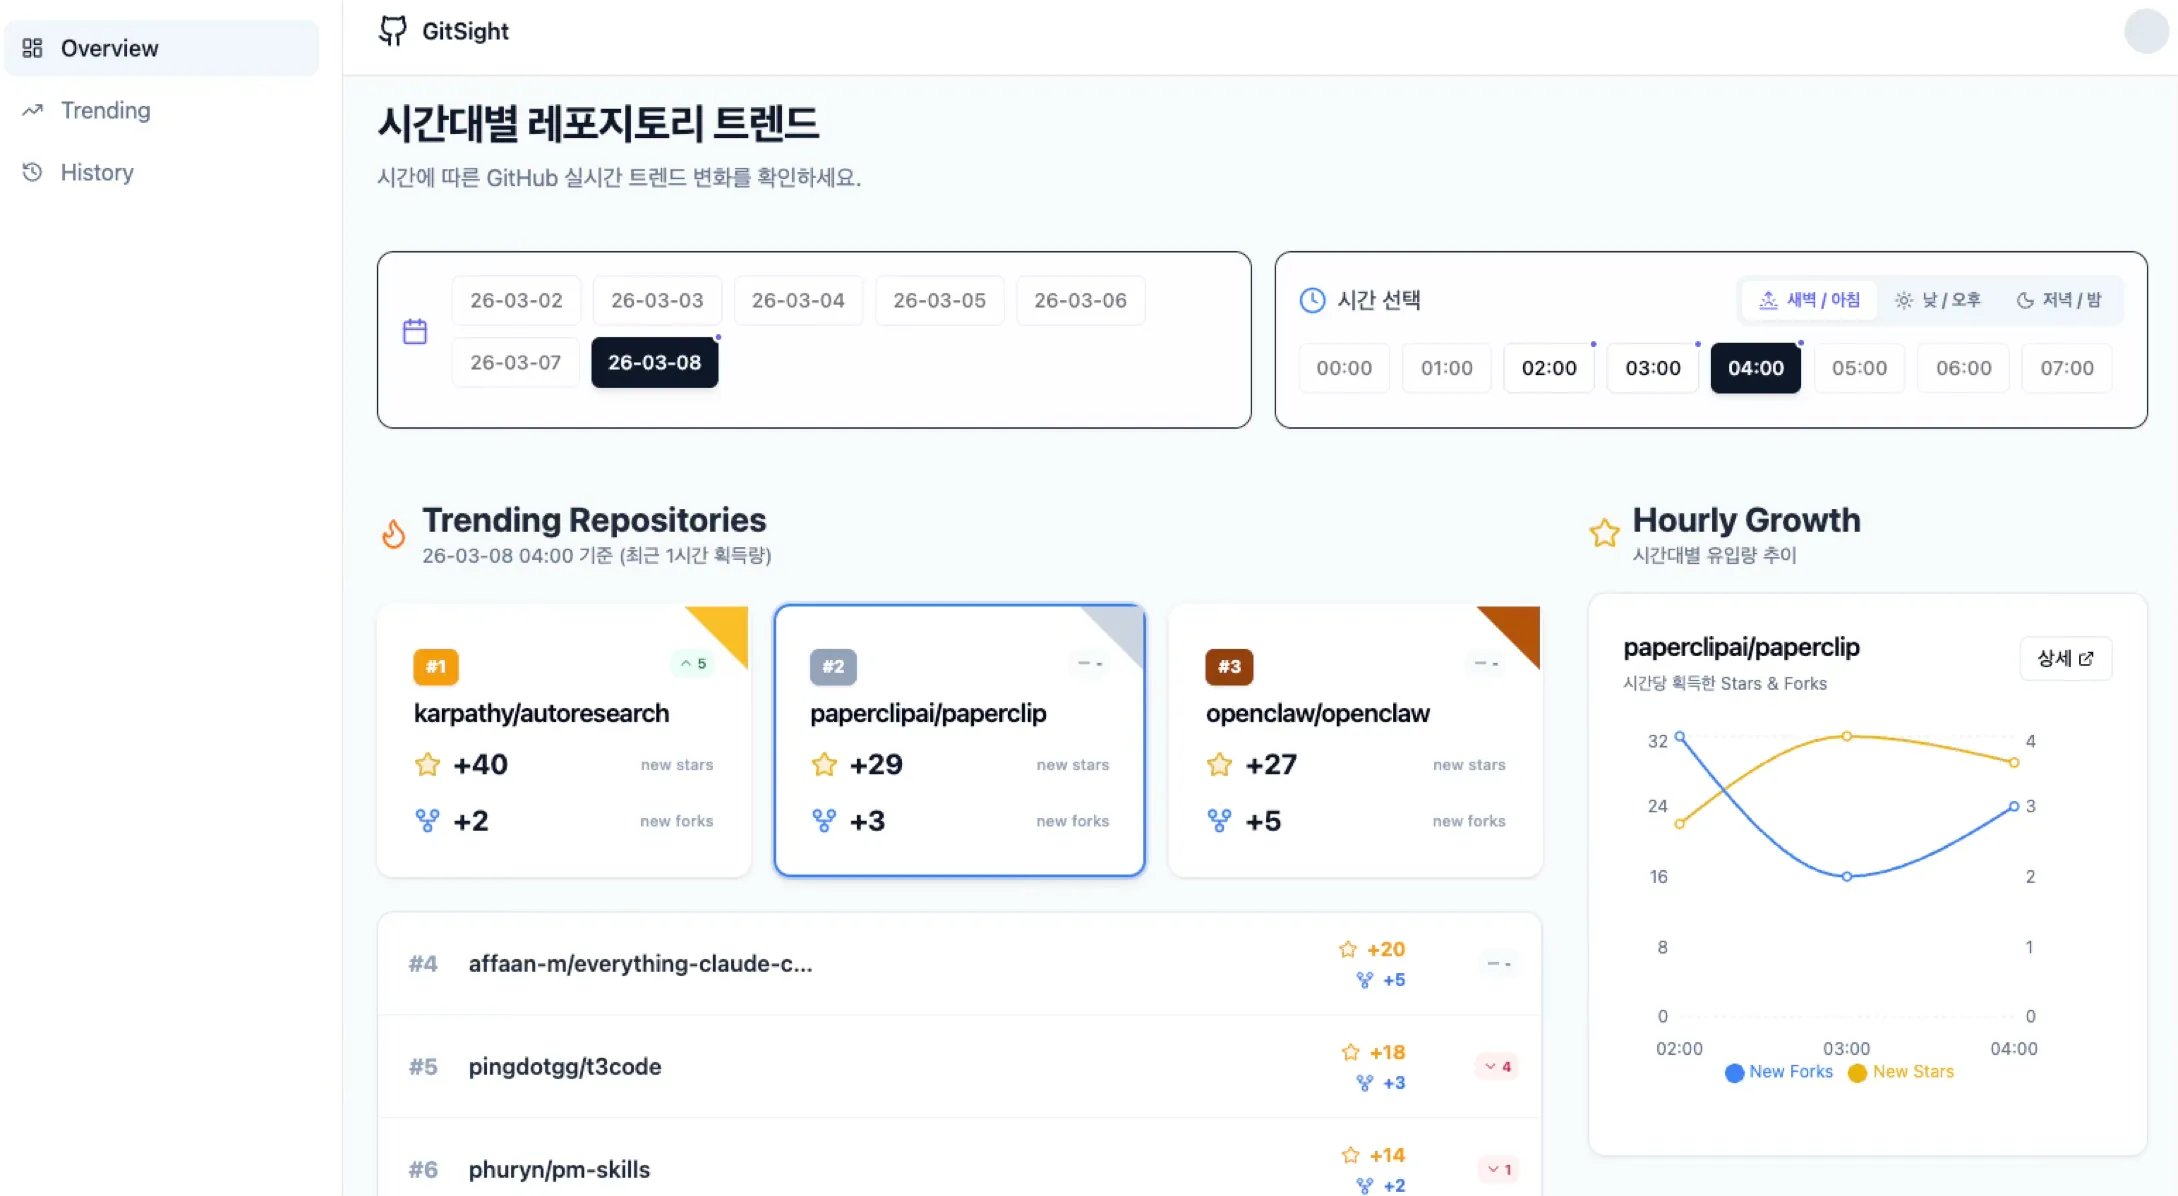
Git Archive에 시간 단위로 적재되는 깃허브 이벤트(Commit, PR, Star)를 활용해 인기를 얻고 있는 레포지토리를 빠르게 발견하고 추적할 수 있는 서비스
개인 프로젝트 (1인) · 2026.03. - 2026.05
기획 배경 및 목적
- 코드 폭발 시대의 도래: AI와 ‘바이브 코딩(Vibe Coding)’ 트렌드로 인해 매일 방대한 양의 새로운 레포지토리와 기술이 쏟아지고 있습니다.
- 기존 Trending의 한계: GitHub의 기본 트렌드 페이지는 일/주/월간 단위의 단순 텍스트 리스트에 그쳐, 실시간으로 부상하는 신기술을 기민하게 포착하기 어렵습니다.
- 입체적 인사이트 부재: 글로벌 통합 지표만으로는 ‘특정 국가에서 현재 어떤 언어와 기술 스택이 인기 있는지’와 같은 지역별 세밀한 트렌드를 파악할 수 없었습니다.
사용한 데이터

- GH Archive: GitHub에서 발생하는 이벤트 로그(Star, Fork, Pull Request, Push 등)가 시간 단위로 적재됩니다.
- GitHub Open API: GH Archive의 이벤트 로그에는 식별자(repo_id, user_id)만 있기 때문에, Dimension 정보(컨트리뷰트 프로필, 국가/지역 정보)를 API 호출을 통해서 적재합니다.
핵심 기능
- 시간 단위 가장 인기 있는 깃허브 레포지토리: 단순 일간 트렌드를 넘어, 실시간에 가까운 시간 단위의 오픈소스 트렌드 파악
- 레포지토리별 인기 변화 히스토리: 특정 프로젝트가 어떤 시점에 폭발적으로 성장했는지 시계열 생명주기 추적
- 국가별 레포지토리 기여도: 글로벌 오픈소스 생태계에서 특정 국가의 개발자들이 어느 레포지토리에 활발히 기여하고 있는지 지리적 분포 분석
- 국가별 인기 레포지토리: 지역(국가)별로 선호하는 기술 스택이나 트렌드 도출
파이프라인
GH Archive와 GitHub Open API를 입력으로 Extract → Transform → Load → Audit 순서의 데이터 ETL/ELT 파이프라인을 거쳐 위 기능에 필요한 데이터를 만듭니다. Audit에서 문제가 발견되면 다시 Extract로 돌아갑니다.

Tech stack
- Data Processing
Apache Spark
Apache Airflow
Python
- Data Storage
MinIO
Apache Iceberg
Postgres
- Data Quality checking & Catalog
Great Expectations
Nessie Catalog
- DevOps
Github Actions
Kubernetes
Helm
ArgoCD
- Visualization & Server
React
Supabase
Troubleshooting
GitOps 기반 선언적 인프라 및 무중단 배포(CI/CD) 환경 구축
K8s 전환으로 복잡해진 수동 배포를 Kaniko 빌드와 ArgoCD GitOps로 100% 자동화
GitOpsArgoCDKanikoGitHub ActionsHelm
Data Lakehouse 아키텍처 설계 및 고도화
오염된 데이터가 Bronze → Silver → Gold로 전파되는 문제를 WAP 패턴(Nessie + Iceberg + Great Expectations)으로 차단
NessieApache IcebergGreat ExpectationsAirflowSpark
k3s 기반 Spark-on-k8s, Airflow 데이터 파이프라인 인프라 설계 및 마이그레이션
트래픽 집중 시간대의 DAG 병목과 상시 가동 Spark 노드의 유휴 자원 낭비를 Spark-on-K8s 동적 할당으로 해소
k3sSpark on K8sAirflowSparkKubernetesOperator