Chapter 2: 아파치 아이스버그 아키텍처
아파치 아이스버그 테이블 아키텍처
아파치 아이스버그 테이블에는 3개의 계층이 있음 카탈로그 계층, 메타데이터 계층, 데이터 계층
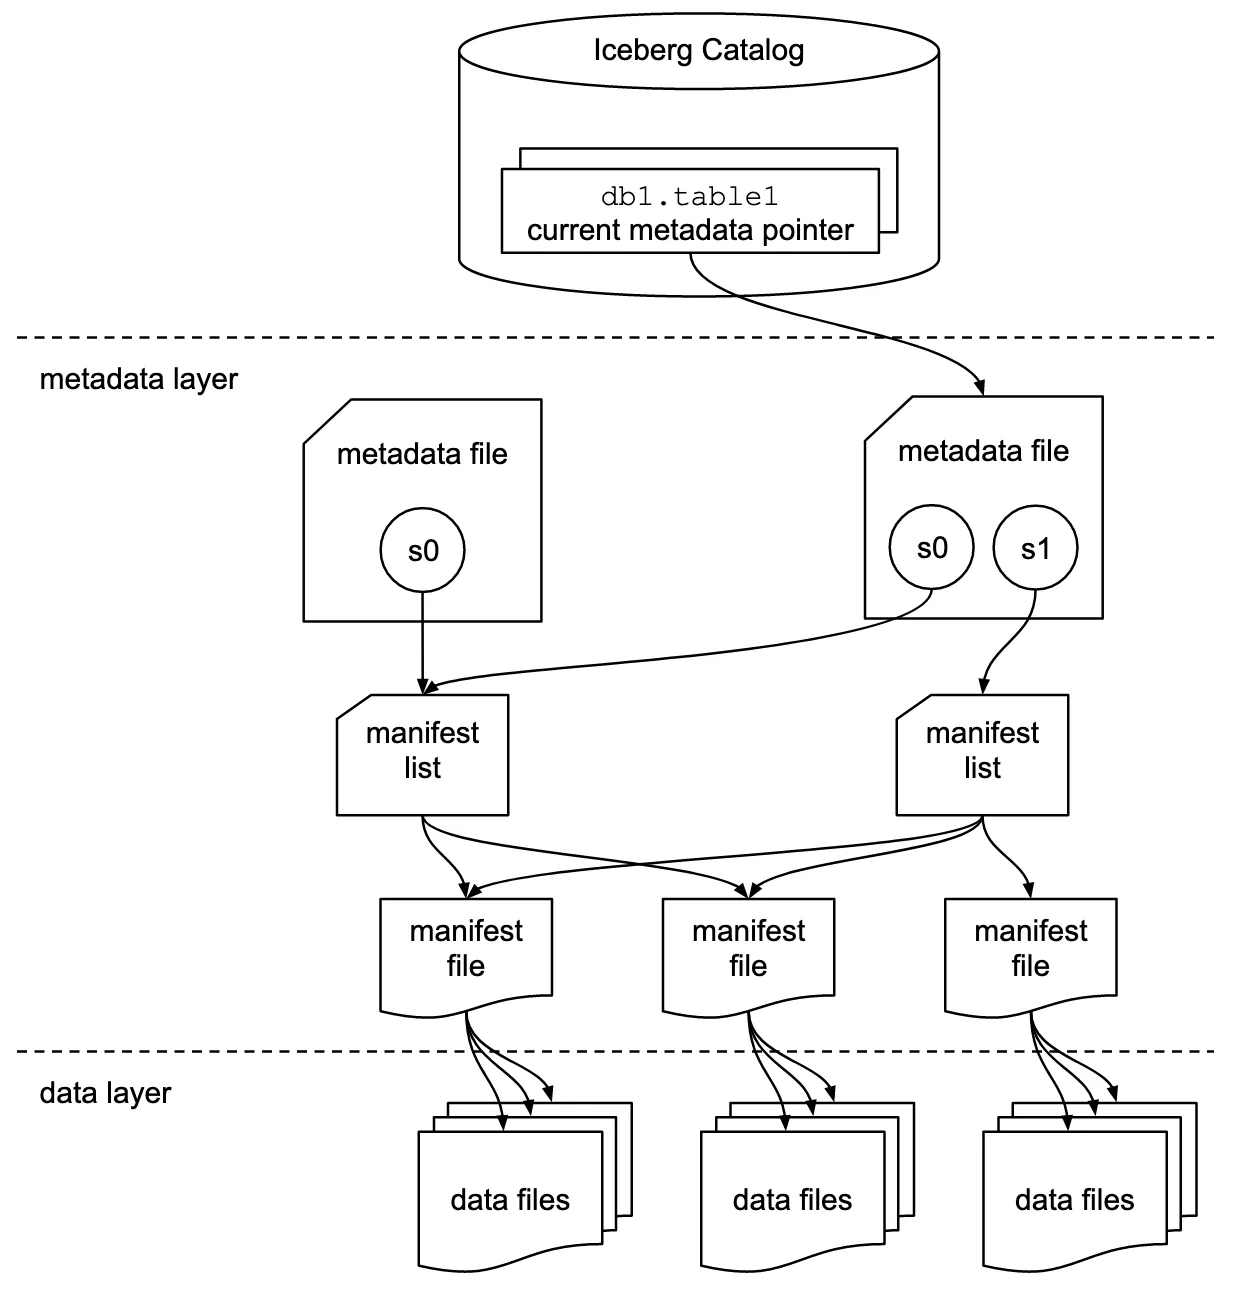
데이터 계층
아파치 아이스버그 테이블의 데이터 계층은 테이블의 실제 데이터를 저장하며,
주로 데이터 파일 그 자체로 구성됨 (+delete file도 포함)
데이터 계층의 파일은 아파치 아이스버그 테이블의 트리(tree) 구조에서 리프(leaf)를 구성
데이터 파일
아파치 아이스버그는 파일 형식에 구애받지 않으며, 다양한 파일 형식을 지원함 (Parquet, ORC, Avro, ...)
- 워크로드에 가장 적합한 형식이 무엇이냐에 따라 다양한 형식을 선택할 수 있는 유연성을 제공
OLAP 작업에서는 파케이 형식을 사용하고, 지연(latency)이 중요한 작업에서는 ORC 형식을 사용할 수 있음
Apache Parquet
실제 환경에서 가장 일반적으로 사용되는 파일 형식은 아파치 파케이 형식
파케이는 특유의 열 구조가 행 기반 파일 형식에 비해 OLAP 워크로드에서 큰 성능 향상을 제공하기 때문에 가장 일반적으로 사용되며, 업계에서 사실상 표준이 되어 거의 모든 엔진과 툴이 파케이를 지원
열 구조는 단일 파일을 여러 방식으로 분할하여, 병렬성을 높이고 각 분할 지점에 대한 통계, 저장소 공간 사용을 줄이고 읽기 처리량을 높이는 향상된 압축 기능을 제공
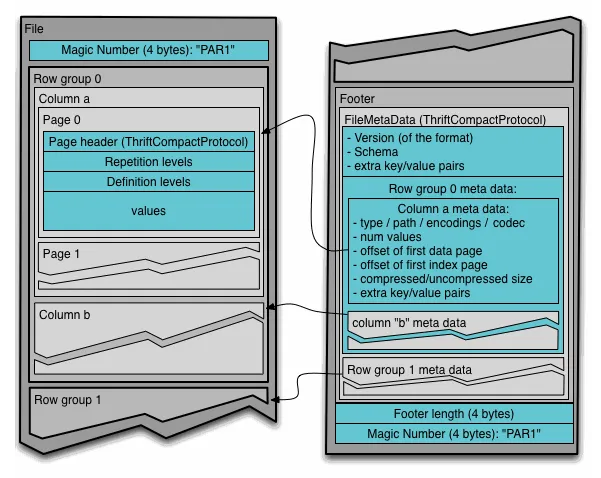
파케이 파일은 파일 → 행 그룹 → 열 → 페이지 순서로 쪼개짐
- 행 그룹(
Row group): 전체 행을 일정 개수씩 묶은 단위
ex) 1~100만 번째 행은Row group 0, 그다음 100만 개는Row group 1 - 열 청크(
Column a,Column b): 하나의 행 그룹 안에서 데이터를 열별로 모아 저장
같은 열의 값끼리 붙어 있으므로 필요한 열만 읽을 수 있고, 비슷한 값끼리 모여 압축률도 높음 - 페이지(
Page 0,Page 1): 열 청크를 다시 작게 나눈 실제 저장/압축 단위
파일 끝의 푸터(Footer) 에는 스키마와 함께 행 그룹별·열별 메타데이터가 들어 있음
- 값 개수, 각 열 데이터의 위치(
offset), 압축 전/후 크기 등 - 엔진은 푸터를 먼저 읽고, 필요한 행 그룹과 열의 위치만 찾아 바로 읽음 → 불필요한 데이터 스캔을 줄임
삭제 파일
삭제 파일은 데이터세트의 어떤 레코드가 삭제되었는지를 기록함
데이터 레이크 저장소는 불변으로 취급하는 것이 좋기 때문에 행을 제자리에서 수정할 수 없음
그래서 변경이 생기면 새 파일을 하나 써야 하고, 방식은 두 가지
- 변경 사항을 반영해 기존 데이터 파일을 통째로 다시 쓰기 → copy-on-write (COW)
- 변경 사항만 별도 파일(삭제 파일)에 기록하기 → merge-on-read (MOR)
삭제 파일은 MOR 방식에서만 사용됨
copy-on-write (COW)
행 하나만 바뀌어도 그 행이 들어 있는 데이터 파일 전체를 새로 써서 교체함
- 읽기: 데이터 파일만 읽으면 되므로 빠름
- 쓰기: 작은 변경에도 파일 전체를 다시 쓰므로 느리고 비용이 큼
변경은 드물고 읽기가 잦은 테이블에 적합
merge-on-read (MOR)
기존 데이터 파일은 그대로 두고, 어떤 행이 삭제/변경되었는지만 삭제 파일에 기록함
업데이트는 기존 행 삭제 + 새 행 추가로 처리됨
읽을 때 엔진이 데이터 파일과 삭제 파일을 합쳐(merge) 최종 결과를 만듦
- 쓰기: 변경분만 쓰므로 빠름
- 읽기: 매번 삭제 파일을 함께 읽고 병합해야 하므로 느려짐 → 주기적인 컴팩션(compaction)으로 삭제 파일을 데이터 파일에 반영해 줘야 함
삭제 파일은 행을 지정하는 방식에 따라 두 종류로 나뉨
- 위치 삭제(
Position delete): 삭제할 행을파일 경로 + 행 위치로 지정
ex)file_a.parquet의 234번째 행 삭제
읽을 때 해당 위치만 건너뛰면 되므로 병합 비용이 적지만, 쓸 때 대상 행의 위치를 먼저 찾아야 함 - 동등 삭제(
Equality delete): 삭제할 행을 컬럼 값으로 지정
ex)order_id = 1234인 행 삭제
위치를 찾을 필요가 없어 쓰기가 가장 빠르지만, 읽을 때 모든 행을 조건과 비교해야 해서 읽기 비용이 큼
정리
| COW | MOR (위치 삭제) | MOR (동등 삭제) | |
|---|---|---|---|
| 쓰기 속도 | 느림 | 빠름 | 가장 빠름 |
| 읽기 속도 | 가장 빠름 | 빠름 | 느림 |
| 적합한 경우 | 읽기 위주, 변경 적음 | 변경 잦음 | 스트리밍처럼 대량·고빈도 쓰기 |
메타데이터 계층
메타데이터 계층은 데이터 파일이 어디에 있고 각 파일에 무엇이 들어 있는지를 추적함
카탈로그가 가리키는 메타데이터 파일에서 시작해 메타데이터 파일 → 매니페스트 목록 → 매니페스트 파일 → 데이터 파일 순서로 내려가는 트리 구조
아래 스키마는 Iceberg 테이블 스펙의 format version 2 기준
매니페스트 파일
매니페스트 파일은 데이터 파일 하나당 항목(entry) 하나를 기록한 Avro 파일
항목에는 파일 경로, 파티션 값, 레코드 수, 열별 통계가 들어 있어서 엔진은 데이터 파일을 열기 전에 읽을 필요가 있는지 판단할 수 있음
- v2부터 데이터 파일을 추적하는 데이터 매니페스트와 삭제 파일을 추적하는 삭제 매니페스트가 서로 다른 파일로 나뉨
- 매니페스트 하나의 파일들은 모두 같은 파티션 스펙으로 쓰임
아이스버그 매니페스트 항목(manifest_entry)의 스키마
| 필드 | 타입 | 설명 |
|---|---|---|
status | int, 필수 | 0: EXISTING, 1: ADDED, 2: DELETED |
snapshot_id | long, 선택 | 파일이 추가된(status=2일 때는 삭제된) 스냅샷 ID. null이면 매니페스트 목록의 값을 상속 |
sequence_number | long, 선택 | 데이터 시퀀스 번호. status가 ADDED이고 null이면 상속 |
file_sequence_number | long, 선택 | 파일이 추가된 시점의 시퀀스 번호. 마찬가지로 null이면 상속 |
data_file | struct, 필수 | 파일 자체에 대한 정보 |
data_file의 주요 필드
| 필드 | 설명 |
|---|---|
content | 0: DATA, 1: POSITION DELETES, 2: EQUALITY DELETES |
file_path | 파일의 전체 경로 |
file_format | PARQUET, ORC, AVRO |
partition | 이 파일의 파티션 값 |
record_count | 레코드 수 |
file_size_in_bytes | 파일 크기 |
column_sizes | 열 ID → 디스크에서 차지하는 크기 |
value_counts | 열 ID → 값 개수 (null, NaN 포함) |
null_value_counts | 열 ID → null 개수 |
nan_value_counts | 열 ID → NaN 개수 |
lower_bounds, upper_bounds | 열 ID → 직렬화된 최솟값, 최댓값 |
equality_ids | 동등 삭제 파일이 비교 기준으로 쓰는 열 ID |
split_offsets | 파일을 나눌 수 있는 위치 (Parquet이면 행 그룹 시작 위치) |
sort_order_id | 파일을 쓸 때 적용한 정렬 순서 ID |
열별 최솟값/최댓값과 null 개수는 파케이 푸터에 있는 통계와 같은 종류
같은 통계를 매니페스트에도 모아 두기 때문에 엔진은 WHERE 조건에 맞지 않는 파일을 열어 보지 않고 건너뜀
매니페스트 목록
매니페스트 목록은 특정 시점에서 본 아이스버그 테이블의 스냅샷
스냅샷 하나마다 매니페스트 목록 파일(Avro) 하나가 생기고, 그 스냅샷을 이루는 매니페스트 파일을 한 줄씩 나열함
엔진은 partitions 요약만 보고 조건과 겹치지 않는 매니페스트를 통째로 건너뜀
아이스버그 매니페스트 목록 파일(manifest_file)의 스키마
| 필드 | 타입 | 설명 |
|---|---|---|
manifest_path | string, 필수 | 매니페스트 파일 경로 |
manifest_length | long, 필수 | 매니페스트 파일 크기(바이트) |
partition_spec_id | int, 필수 | 매니페스트를 쓸 때 사용한 파티션 스펙 ID |
content | int, 필수 | 0: 데이터 매니페스트, 1: 삭제 매니페스트 |
sequence_number | long, 필수 | 매니페스트가 테이블에 추가된 시점의 시퀀스 번호 |
min_sequence_number | long, 필수 | 매니페스트 안 파일들의 데이터 시퀀스 번호 중 가장 작은 값 |
added_snapshot_id | long, 필수 | 매니페스트를 추가한 스냅샷 ID |
added_files_count, existing_files_count, deleted_files_count | int, 필수 | 항목 상태별 파일 개수 |
added_rows_count, existing_rows_count, deleted_rows_count | long, 필수 | 항목 상태별 행 개수 |
partitions | list<field_summary>, 선택 | 파티션 필드별 요약 |
key_metadata | binary, 선택 | 암호화 키 메타데이터 |
field_summary의 스키마 (파티션 필드 하나당 한 항목)
| 필드 | 타입 | 설명 |
|---|---|---|
contains_null | boolean, 필수 | 매니페스트 안에 이 필드가 null인 파티션이 있는지 |
contains_nan | boolean, 선택 | NaN인 파티션이 있는지 |
lower_bound | binary, 선택 | null과 NaN을 뺀 최솟값 |
upper_bound | binary, 선택 | null과 NaN을 뺀 최댓값 |
시퀀스 번호
v2에서 추가된 시퀀스 번호는 커밋할 때마다 증가하며 변경의 순서를 정함
삭제 파일이 어떤 데이터 파일에 적용되는지도 이 번호로 결정됨
- 위치 삭제 파일: 시퀀스 번호가 자기보다 작거나 같은 데이터 파일에 적용
- 동등 삭제 파일: 시퀀스 번호가 자기보다 작은 데이터 파일에만 적용
메타데이터 파일
메타데이터 파일은 테이블의 현재 상태를 담은 JSON 파일이며, 카탈로그가 가리키는 트리의 시작점
테이블을 바꿀 때마다 기존 파일을 고치지 않고 새 메타데이터 파일을 쓴 뒤, 카탈로그의 포인터를 새 파일로 바꿈
아이스버그 메타데이터 파일의 스키마
| 필드 | 필수 여부 | 설명 |
|---|---|---|
format-version | 필수 | 테이블 포맷 버전 (여기서는 2) |
table-uuid | 필수 | 테이블 생성 시 만든 UUID. 갱신 후 값이 달라졌다면 다른 테이블이므로 실패해야 함 |
location | 필수 | 테이블 기본 경로 |
last-sequence-number | 필수 | 마지막으로 할당한 시퀀스 번호 |
last-updated-ms | 필수 | 마지막 갱신 시각 |
last-column-id | 필수 | 마지막으로 할당한 열 ID |
schemas | 필수 | 지금까지의 스키마 목록 |
current-schema-id | 필수 | 현재 스키마 ID |
partition-specs | 필수 | 지금까지의 파티션 스펙 목록 |
default-spec-id | 필수 | 새 데이터에 쓰는 파티션 스펙 ID |
last-partition-id | 필수 | 마지막으로 할당한 파티션 필드 ID |
sort-orders | 필수 | 정렬 순서 목록 |
default-sort-order-id | 필수 | 기본 정렬 순서 ID |
properties | 선택 | 테이블 속성 (key-value) |
current-snapshot-id | 선택 | 현재 스냅샷 ID. refs의 main 브랜치와 같아야 함 |
snapshots | 선택 | 스냅샷 목록 |
snapshot-log | 선택 | 현재 스냅샷이 바뀐 이력 (snapshot-id, timestamp-ms) |
metadata-log | 선택 | 이전 메타데이터 파일 이력 (metadata-file, timestamp-ms) |
refs | 선택 | 브랜치와 태그 이름 → 스냅샷 매핑. main 브랜치는 항상 존재 |
statistics | 선택 | 스냅샷별 Puffin 통계 파일 |
partition-statistics | 선택 | 스냅샷별 파티션 통계 파일 |
schemas와 partition-specs가 현재 값만이 아니라 과거 값까지 목록으로 들고 있기 때문에, 스키마나 파티션 구성을 바꿔도 예전 데이터 파일을 다시 쓰지 않고 읽을 수 있음
snapshots의 각 항목은 snapshot-id, parent-snapshot-id, sequence-number, timestamp-ms, summary(operation:
append, replace, overwrite, delete), schema-id와 함께 manifest-list 경로를 가짐
이 경로가 메타데이터 파일에서 매니페스트 목록으로 내려가는 연결 고리
카탈로그
테이블과 상호작용하는 첫 번째 단계는 현재 메타데이터를 가리키는 메타데이터 파일의 위치를 알아내는 것으로, 현재 메타데이터에 대한 포인터의 위치를 찾을 수 있는 중앙 저장소가 아이스버그 카탈로그(catalog)
아이스버그 카탈로그의 기본 요구 사항은 현재 메타데이터 포인터를 업데이트하기 위한 원자적 연산(atomic operation) 을 지원해야 함
-- 테이블의 현재 상태, 메타데이터 파일의 위치에 대한 상세 내역 확인

SELECT *
FROM my_catalog.iceberg_book.my_table.metadata_log_entries
ORDER BY TIMESTAMP DESC
    LIMIT 1

/*
+---------------------+----------------------------------------------------+--------------------+------------------+------------------------+
| timestamp           | file                                               | latest_snapshot_id | latest_schema_id | latest_sequence_number |
+---------------------+----------------------------------------------------+--------------------+------------------+------------------------+
| 2026-11-14 09:41:27 | s3://wh/my_table/metadata/00003-8e1d.metadata.json | 3821550127947      | 0                | 3                      |
+---------------------+----------------------------------------------------+--------------------+------------------+------------------------+
*/timestamp: 이 메타데이터 파일이 만들어진 시각file: 메타데이터 파일의 위치. 파일 이름 앞의00003은 테이블이 세 번 갱신되었다는 뜻latest_snapshot_id: 이 메타데이터 파일 기준의 현재 스냅샷 IDlatest_schema_id: 이 시점에 쓰는 스키마 IDlatest_sequence_number: 이 시점의 마지막 시퀀스 번호
ACID와 카탈로그
ACID는 아이스버그 테이블 스펙이 정의하는 보장이지만, 스펙은 메타데이터 파일 포인터를 원자적으로 교체할 수 있어야 한다는 조건만 걸고 교체 자체는 카탈로그에 맡김
카탈로그가 없거나 원자적 교체를 지원하지 못하면 ACID를 보장받을 수 없음
데이터 파일, 매니페스트, 메타데이터 파일은 한번 쓰면 바뀌지 않는 불변 파일이라 오브젝트 스토리지에 써 두어도 포인터가 바뀌기 전까지는 테이블에 영향을 주지 않음
따라서 커밋은 카탈로그의 포인터를 새 메타데이터 파일로 바꾸는 한 번의 연산이고, ACID는 이 연산이 얼마나 안전하게 수행되느냐에 달려 있음
커밋 과정 (낙관적 동시성 제어)
- 현재 메타데이터 파일(base)을 읽음
- 새 데이터 파일, 매니페스트, 매니페스트 목록, 새 메타데이터 파일을 씀 (아직 아무도 모르는 파일)
- 카탈로그에 “포인터가 아직 base라면 새 메타데이터 파일로 바꿔 달라”고 요청함
- 그 사이 다른 쓰기가 먼저 커밋해 포인터가 바뀌었다면 요청은 실패하고, 새로 바뀐 메타데이터를 base로 삼아 다시 시도함
| ACID | 아이스버그에서 보장하는 방식 | 카탈로그의 역할 |
|---|---|---|
| 원자성(Atomicity) | 새 파일은 포인터를 바꾸기 전까지 보이지 않고, 바꾼 뒤에는 변경 전체가 한 번에 보임 | 포인터 교체가 전부 성공하거나 전부 실패하도록 보장 |
| 일관성(Consistency) | 읽기는 항상 메타데이터 파일 하나가 가리키는 스냅샷 하나만 읽으므로 일부만 반영된 상태를 볼 수 없음 | 하나의 현재 포인터만 유지 |
| 격리성(Isolation) | 읽기는 로딩 시점의 스냅샷을 쓰므로 진행 중인 쓰기에 영향받지 않고, 동시 쓰기는 낙관적 동시성 제어로 직렬화됨 | 기대한 base와 현재 포인터가 같을 때만 교체 (compare-and-swap) |
| 지속성(Durability) | 커밋된 파일은 불변이며 오브젝트 스토리지에 저장됨 | 교체된 포인터를 영구히 보관 |
커밋이 실패하면 이미 써 둔 데이터 파일과 메타데이터 파일이 어디에서도 참조되지 않은 채 남음
이런 고아 파일(orphan file)은 remove_orphan_files 프로시저로 정리함
S3 같은 오브젝트 스토리지는 원자적 이름 변경(rename)을 제공하지 않아서, 파일 시스템 위에서 포인터를 바꾸는 방식(HadoopCatalog)은 안전하지 않음
그래서 운영 환경에서는 Hive Metastore, JDBC, AWS Glue, REST, Nessie 같은 카탈로그가 포인터 교체를 맡음